 یوسف فرحمند
یک سیستم لیدربورد که ۱,۰۰۰,۰۰۰ رکورد را از فایل CSV میخواند، مرتب میکند و قابل جستجو نگه میدارد، بدون اینکه Main Thread را حتی یک فریم بلاک کند. هدف اصلی این پروژه دقیقاً همین است: نشان بدهم چطور با Unity Job System و Burst میشود حجم بالای داده را بدون افت فریمریت و بدون فشار غیرضروری روی حافظه مدیریت کرد.
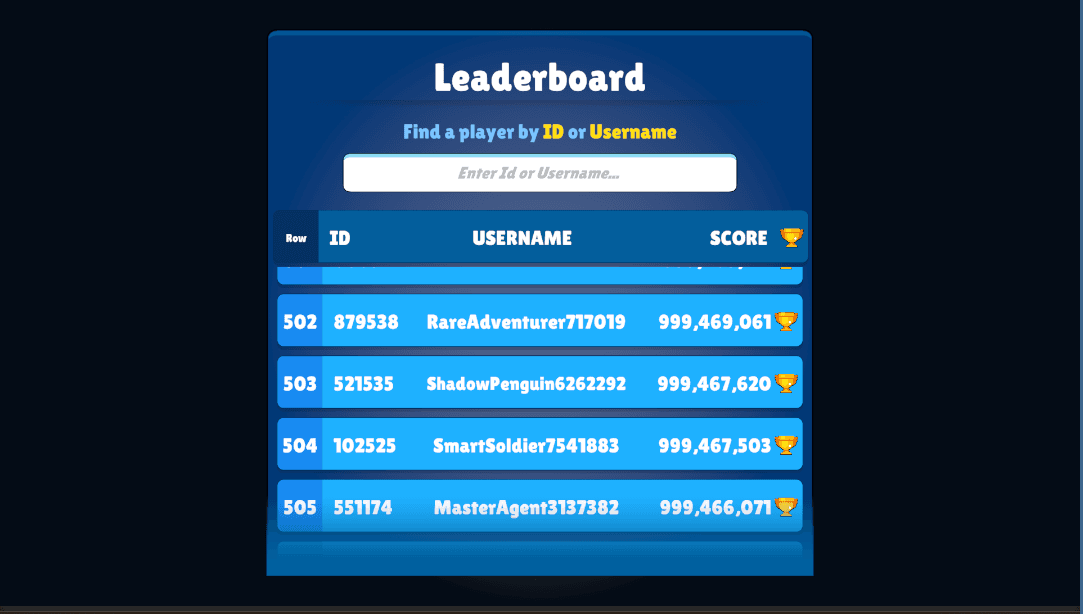
ساختار پروژه
اسکریپتها در این پوشهها سازماندهی شدهاند:
Application: فایلManager.cs، هماهنگکنندهٔ کل جریان (Load → Sort → Search → UI)Core:LoadService،SortService،SearchServiceData:FileReader،LeaderboardEntry،FindLineOffsetsJob،ParseLineJobSearch:IdSearchJob،UsernameSearchJobSorting:SortJobUI:LeaderboardUIManager،ItemScrollView،ItemContainer،ItemSlot،SearchInputTest: ابزارهای دیباگ و اندازهگیری Performance، از جملهLeaderboardProfilerReport
منطق Data/Processing (Core، Data، Search، Sorting) را کاملاً از UI جدا نگه داشتم. این دو لایه فقط از طریق Manager به هم وصل میشوند و هرکدام را میشود مستقل تست کرد.
۱. بارگذاری و Parse دادهها
FileReader.ReadAsyncباFile.ReadAllBytesAsyncفایل را بهصورت async میخواند و سپس بایتها را در یکNativeArray<byte>کپی میکند.FindLineOffsetsJob(IJob، Burst) یکبار کل بافر بایت را اسکن میکند و ابتدا و طول هر خط را پیدا میکند (پشتیبانی از\nو\r\n).ParseLineJob(IJobParallelFor، Burst، batch size ۶۴) هر خط را موازی Parse میکند؛ مستقیم روی بایتها و بدونstring.Split، تا GC Allocation و سربار تبدیل رشته صفر بماند. نتیجه در یکNativeArray<LeaderboardEntry>باAllocator.Persistentذخیره میشود.
چون Parse نسبتاً سنگین است، هر دو Job را با همان الگویی که برای Sort و Search استفاده کردم (پایینتر توضیح میدهم) منتظر میمانم: یک متد کمکی به اسم WaitForJobAsync بهجای صدا زدن مستقیم Complete()، در طول چند فریم و با Awaitable.NextFrameAsync مقدار JobHandle.IsCompleted را چک میکند. به این ترتیب Main Thread هیچوقت منتظر تمامشدن Job نمیماند.
چون این انتظار ممکن است بیشتر از یک فریم طول بکشد، بافرهای میانی (lineStartOffsets و lineLengths) را با Allocator.Persistent میسازم، نه Allocator.TempJob (که فقط برای چند فریم معتبر است). WaitForJobAsync هم تکمیل Job را داخل یک finally انجام میدهد تا حتی اگر انتظار وسط راه قطع شود (مثلاً با خروج از Play Mode)، Dispose بعدی بدون خطا انجام شود.
۲. مرتبسازی
SortJob (IJob، Burst) از متد داخلی NativeArray<T>.Sort(IComparer<T>) استفاده میکند (Introsort در Unity.Collections) و روی Score نزولی مرتب میکند. اجرا روی یک Worker Thread است و تکمیلش با poll کردن IsCompleted در SortService.Update() چک میشود.
۳. جستجو و فیلتر
- ورودی کاربر با Debounce (
SearchInput، ۰.۱۵ ثانیه) کنترل میشود تا هر keystroke یک Job جدید نسازد. - اگر Query عددی باشد،
IdSearchJobاجرا میشود (Prefix match روی ID). در غیر اینصورتUsernameSearchJob(Prefix match بهصورت Case-insensitive رویFixedString64Bytes). - هر دو Job از نوع
IJobParallelForهستند و کل ۱ میلیون رکورد را موازی اسکن میکنند. نتایج باNativeList<int>.ParallelWriterو بدون Resize جمع میشوند، چون Capacity از قبل به اندازهٔ کل رکوردها رزرو شده است. SearchServiceهم مثلSortServiceبا poll کردنIsCompletedکار میکند. اگر کاربر در حین اجرای یک جستجو Query جدید بفرستد، فقط آخرین Query نگه داشته میشود و بعد از اتمام جستجوی جاری اجرا میشود.
۴. نمایش و اسکرول (UI)
- Object Pooling:
ItemContainerفقط بهاندازهٔ آیتمهای قابلمشاهده در Viewport (بهعلاوهٔ Buffer) آبجکت میسازد، نه بهاندازهٔ کل رکوردها. - Virtualization:
ItemScrollViewبر اساس موقعیت اسکرول، ایندکس اولین آیتم قابلنمایش را محاسبه میکند و فقط پول موجود را Reposition/Repopulate میکند. - نتایج فیلترشده هم از همین مسیر (
SetResults) رد میشوند، پس رفتار برای «همهٔ رکوردها» و «نتایج جستجو» یکسان است.
سؤالهای رایج طراحی
چرا Awaitable بهجای Task یا UniTask؟
Awaitable بومی موتور Unity است (۲۰۲۳.۱ به بعد)، مستقیم با PlayerLoop یکپارچه است و بدون نیاز به پکیج خارجی کار میکند. برخلاف Task، به Thread Pool و SynchronizationContext معمول .NET وابسته نیست؛ Allocation کمتری تولید میکند و برای سناریوهای per-frame و per-operation در Unity سبکتر است. Cancellation خودکار هنگام از بین رفتن آبجکت هم built-in پشتیبانی میشود. تنها محدودیتش این است که فقط روی Unity 2023.1+ در دسترس است و اکوسیستمش هنوز به بلوغ UniTask نرسیده.
چرا Parse با IJobParallelFor و batch size ۶۴؟
Parse هر خط مستقل از خطهای دیگر است (Embarrassingly Parallel)، پس موازیسازی انتخاب طبیعی است. batch size ۶۴ تعادلی بین سربار زمانبندی هر Batch و بهرهوری از Worker Threadها برقرار میکند:
| Batch Size | سربار زمانبندی | توازن بار بین Threadها | نتیجه |
|---|---|---|---|
| ۳۲ یا کمتر | بالا: تعداد Batchهای بیشتر یعنی سربار Dispatch بیشتر | خوب | رد شد: سربار زمانبندی سود موازیسازی را میخورد |
| ۶۴ | پایین | خوب | انتخاب شد |
| ۱۲۸ یا بیشتر | خیلی پایین | ضعیف: تعداد Batch کمتر از Coreهای موجود میشود و بعضی Threadها بیکار میمانند | رد شد: Threadها بهشکل نامتوازن مشغول میشوند |
چرا خطوط با یک Job تکرشتهای (IJob) پیدا میشوند، نه Parallel؟
پیدا کردن مرز خطوط یک اسکن ترتیبی ساده روی بایتهاست که حتی بهصورت تکرشته و Burst-compiled برای چند ده مگابایت داده در حد چند میلیثانیه طول میکشد. موازیسازیاش نیاز به merge کردن نتایج بین Chunkها دارد؛ پیچیدگی اضافهای که در این مقیاس سود محسوسی ندارد.
چرا مرتبسازی با NativeArray<T>.Sort (Introsort) و نه یک الگوریتم دستساز؟
Introsort توکار Unity.Collections برای ۱ میلیون آیتم عملکرد O(n log n) قابلقبولی دارد و روی یک Worker Thread اجرا میشود، بدون اینکه Main Thread را بلاک کند. یک Radix Sort روی Score (چون عدد صحیح است، بالقوه O(n)) یا یک Merge Sort موازی سریعتر میبود، ولی چون Sort فقط یکبار در Load انجام میشود (نه در هر جستجو)، پیچیدگی اضافهاش در برابر سودش رد شد. Sort روی ۱ میلیون رکورد در پروفایل واقعی (جدول پایینتر) ۱۱۴.۵۱ میلیثانیه روی ۳ فریم پخش شده، بدون عبور از ۵۹.۸۹ میلیثانیه در بدترین فریم؛ پس Introsort توکار برای این حجم داده کافی است.
چرا جستجو Linear Scan موازی است، نه Hash Map یا Trie؟
برای Username به Prefix Match نیاز داریم. یک Hash Map معمولی فقط Exact Match را O(1) میکند و برای Prefix باید Trie ساخت که حافظه و پیچیدگی بیشتری دارد. چون IDها به ترتیب ورود Parse میشوند (نه sorted بر اساس ID)، برای Binary Search هم باید یک ایندکس اضافه نگهداری شود. ساخت و نگهداری یک ایندکس اضافه (حافظهٔ بیشتر، پیچیدگی Invalidation) در برابر سودش رد شد: با موازیسازی روی همهٔ Coreهای CPU، یک Scan خطی روی ۱ میلیون رکورد در پروفایل واقعی (۴۰۱ Query نمونه، جدول پایینتر) بهطور میانگین ۱۲.۶۴ میلیثانیه برای ID و ۱۵.۵۵ میلیثانیه برای Username طول کشیده، مستقل از اینکه Query صفر Match داشته یا ۱۱۱,۱۱۲ تا. برای این مقیاس کافی است.
چرا Debounce روی ورودی جستجو، و چرا ۰.۱۵ ثانیه؟
بدون Debounce هر keystroke یک Job موازی روی ۱ میلیون رکورد میسازد؛ هم اتلاف منابع است، هم Race بین نتایج جستجوهای پیاپی. ۰.۱۵ ثانیه به اندازهٔ کافی کوتاه است که UI بیواسطه حس شود، ولی جلوی Jobسازی برای هر حرف تایپشده را میگیرد.
چرا Sort و Search در Update() poll میشوند، نه Complete() مستقیم؟
JobHandle.Complete() مستقیم بعد از Schedule() معادل بلاک کردن Main Thread تا پایان Job است. با چک کردن IsCompleted در هر فریم داخل Update()، Main Thread هیچوقت منتظر نمیماند و فریمریت پایین نمیآید؛ نتیجه فقط وقتی مصرف میشود که Job واقعاً تمام شده باشد.
چرا لیست ۱ میلیونی UI را Freeze نمیکند؟
با ترکیب Object Pooling (فقط آیتمهای قابلدید ساخته میشوند) و Virtualization (موقعیت هر آیتم پول بر اساس Scroll Offset دوباره محاسبه میشود، نه اینکه کل لیست دوباره رندر شود). هزینهٔ رندر مستقل از تعداد کل رکوردهاست و فقط به تعداد آیتمهای داخل Viewport وابسته است.
محدودیتها و Trade-offها
FixedString64Bytesبرای Username ظرفیت محدودی دارد (حدود ۶۱ بایت UTF8)؛ یوزرنیمهای طولانیتر Truncate یا Error میشوند.- خواندن فایل فعلاً دو کپی از داده در حافظه ایجاد میکند (
byte[]مدیریتشده وNativeArray<byte>)؛ برای فایلهای خیلی بزرگتر میشود با خواندن مستقیم در بافر Native این هزینه را حذف کرد. - جستجو با هر Query یک Full Scan جدید روی کل داده انجام میدهد (بدون Index)؛ برای مقیاسهای بسیار بزرگتر از ۱ میلیون، ساخت ایندکس جانبی ممکن است لازم شود.
- ارتفاع خیلی زیاد
Contentدر ScrollRect (متناسب با ۱ میلیون آیتم) از نظر دقت float برای رکوردهای انتهای لیست تست دقیق نشده؛ ارزش دارد با اسکرول سریع تا انتها بررسی شود. - کلاسهای داخل
Test/ابزار دیباگ و اندازهگیری دستی هستند و بخشی از جریان اصلی محصول نیستند.
Profiler و نتایج عملکرد
اسکریپت LeaderboardProfilerReport (داخل Test/) مراحل Read → FindLines → Parse → Sort → Search را یکبار در Editor اجرا کرد و زمان هر مرحله (Wall time)، تعداد فریمهای طیشده و بدترین فریمتایم را اندازه گرفت. یک جدول Markdown کامل هم در Console چاپ کرد و هم در فایل leaderboard_profiler_report.md ذخیره کرد؛ همان فایلی که پیوست مخزن است و جزئیات هر ۴۰۱ Query نمونه (ID و Username، هرکدام شامل دادهی واقعی، نامعتبر و پارشال) را جداگانه دارد. جدول پایین خلاصهٔ همان فایل است.
اسکرول با این ابزار اندازهگیری نشد، چون به شبیهسازی واقعی لمس یا درگ نیاز دارد. عدد اسکرول از تصویر و ویدیوی زیر (Unity Profiler، PlayerLoop، داخل Editor، حین اسکرول واقعی لیست) گرفته شده است.
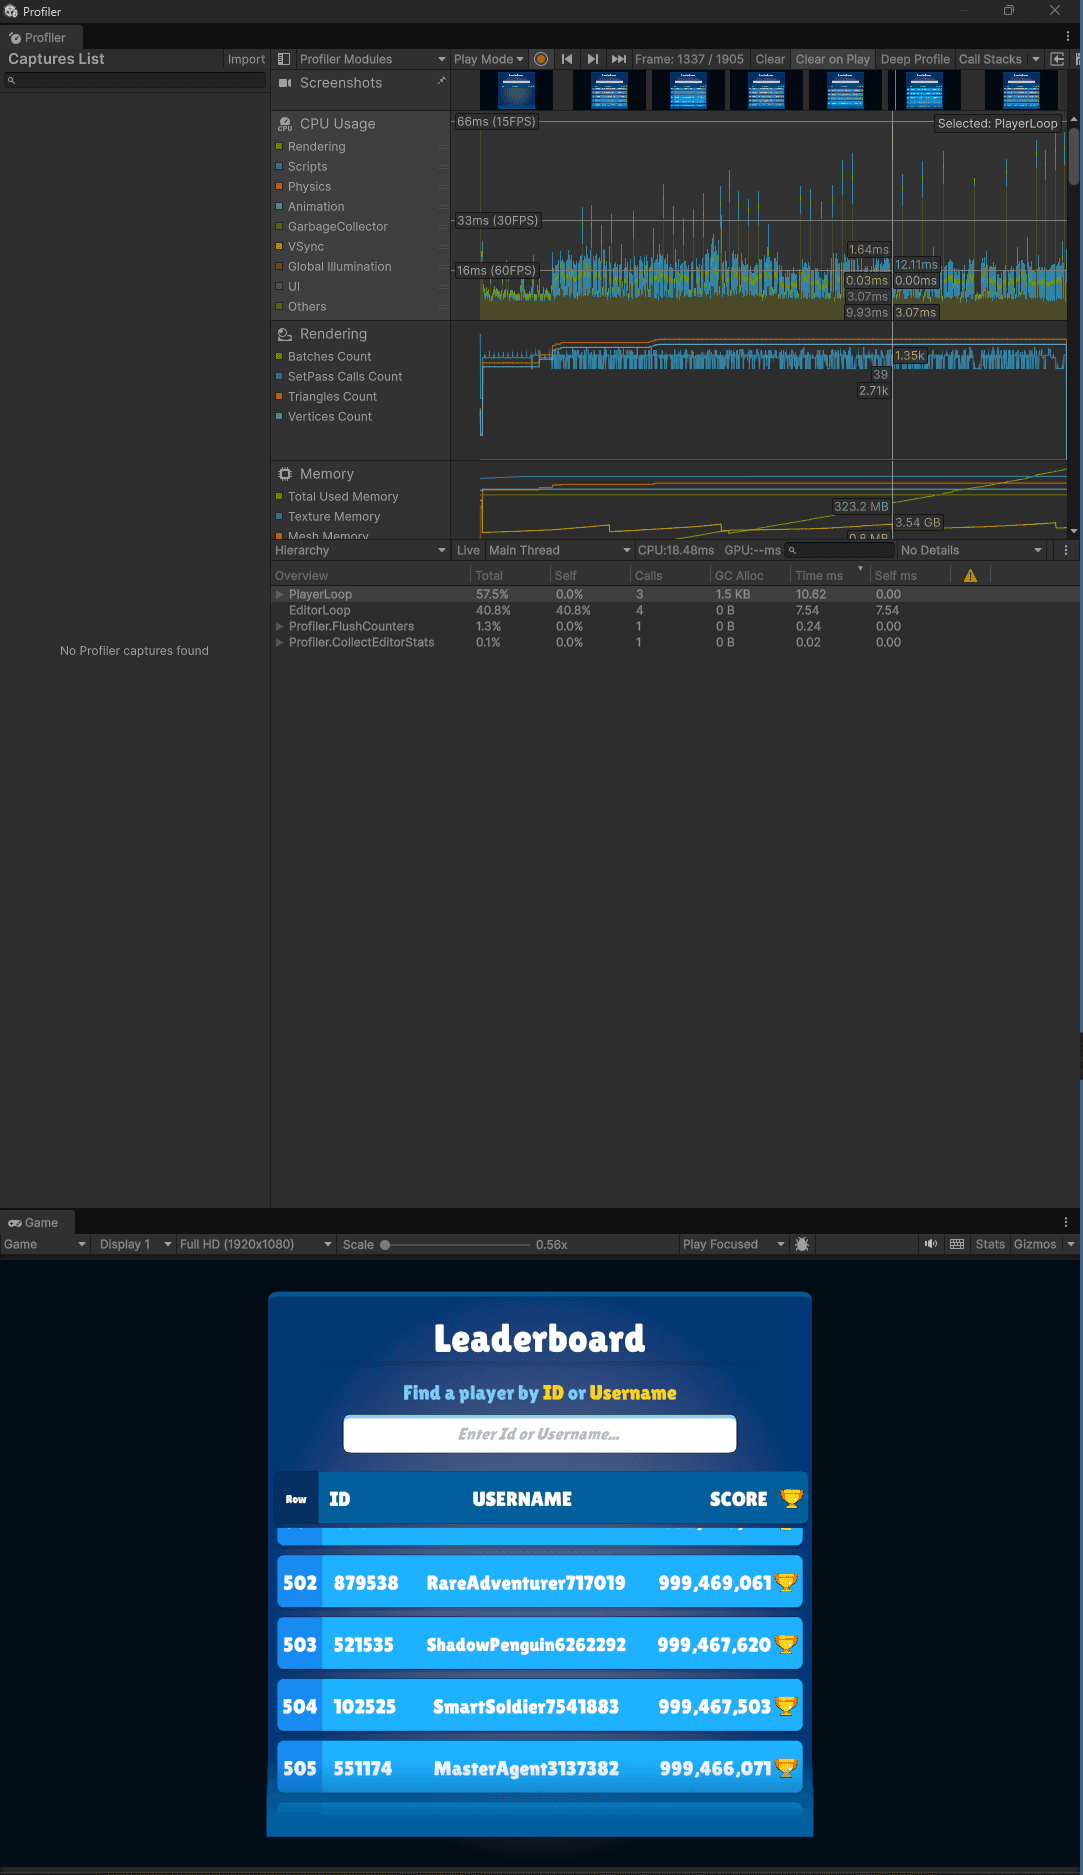
ویدیوی Profiler + Search زنده فریمتایم Profiler را همزمان با تایپ در فیلد جستجو نشان میدهد. هیچ Spike محسوسی روی CPU Usage در لحظهٔ Search دیده نمیشود، چون Job موازی روی Worker Threadهاست، نه Main Thread.
| Stage | Wall time (ms) | Frames elapsed | Worst single frame (ms) | توضیحات |
|---|---|---|---|---|
| File read (I/O) | 44.97 | 1 | 44.38 | ۳۷٬۱۳۷٬۸۱۵ بایت |
| Line-offset scan | 112.33 | 1 | 156.96 | ۱٬۰۰۰٬۰۰۱ خط |
| Parse (۱M رکورد) | 72.66 | 1 | 96.15 | ۱٬۰۰۰٬۰۰۰ رکورد |
| Sort (۱M رکورد) | 114.51 | 3 | 59.89 | نزولی بر اساس Score |
| Search ID (۴۰۱ Query) | میانگین 12.64 / بیشینه 112.04 | ۱ به ازای هر Query | میانگین 12.95 / بیشینه 119.18 | نتایج هر Query بین ۰ تا ۱۱۱٬۱۱۲ رکورد |
| Search Username (۴۰۱ Query) | میانگین 15.55 / بیشینه 44.81 | ۱ به ازای هر Query | میانگین 15.87 / بیشینه 45.26 | نتایج هر Query بین ۰ تا ۱۴٬۲۷۰ رکورد |
| اسکرول در حالت پایدار | - | - | 10.62 | بدترین فریم حین اسکرول سریع تا انتهای لیست (ردیف PlayerLoop در تصویر Profiler بالا) |
این اعداد داخل Editor گرفته شدهاند و شامل هزینهٔ EditorLoop نیستند، چون جدا در Hierarchy گزارش میشود و در Build واقعی اصلاً وجود ندارد؛ یعنی روی یک Development Build این اعداد پایینترند، نه بالاتر.
مقایسهٔ Search روی ID و Username
| معیار | ID Search | Username Search |
|---|---|---|
| میانگین Wall time | 12.64ms | 15.55ms |
| بیشینه Wall time | 112.04ms | 44.81ms |
| میانگین بدترین فریم | 12.95ms | 15.87ms |
| بیشینه بدترین فریم | 119.18ms | 45.26ms |
| بازهٔ تعداد Match | ۰ تا ۱۱۱٬۱۱۲ | ۰ تا ۱۴٬۲۷۰ |
Username Search بهطور میانگین حدود ۳ میلیثانیه از ID Search کندتر است، چون FixedString64Bytes به مقایسهٔ Case-insensitive بایتبهبایت نیاز دارد، در حالی که ID Search یک مقایسهٔ عددی ساده است. بیشینهٔ بالاتر برای ID (۱۱۲.۰۴ms در برابر ۴۴.۸۱ms) مربوط به یک Query تکی است، نه یک الگوی پایدار؛ بیشینهٔ دوم و سوم ID Search هم در همان بازهٔ ۲۰ تا ۳۲ میلیثانیهٔ Username Search قرار دارند. Queryهایی که Overhead بالاتری نشان میدهند (بالای ۲۰ms) عمدتاً در نیمهٔ دوم اجرا اتفاق افتادهاند؛ این ناشی از تجمع بیش از ۸۰۰ خط Debug.Log در همین اسکریپت تشخیصی است، نه از خود Job Search. روی Search واقعی UI (بدون Log اضافه) این افزایش وجود ندارد.
پیک حافظهٔ Native برای آرایهٔ اصلی: ۸۳.۹۲ مگابایت (۱٬۰۰۰٬۰۰۰ رکورد × ۸۸ بایت).
مصرف حافظهٔ Managed گزارششده در این اجرا افت −۵۱۷,۶۸۲ کیلوبایت بود. عدد منفی نشاندهندهٔ یک پاس Garbage Collection حین اجراست، نه یک نشت حافظه. این عدد به Pipeline اصلی ربطی ندارد: Profiler.GetTotalAllocatedMemoryLong() مجموع تجمعی Allocation کل Session را میدهد، نه مصرف فعلی، و بخش بزرگی از نوسان از خود اسکریپت تشخیصی میآید (بیش از ۸۰۰ خط Log فرمتشده). برای عدد دقیق مصرف واقعی Pipeline باید یک Snapshot جدا با Memory Profiler از یک اجرای عادی (بدون این ابزار تست) گرفته شود.
نتیجهگیری کلی از پروفایل: هزینهٔ هر Search عملاً مستقل از تعداد Matchهاست (چه ۰ رکورد چه ۱۱۱٬۱۱۲ رکورد، زمان اجرا در همان بازهٔ چند-میلیثانیهای میماند)؛ دقیقاً همان رفتاری که از یک Scan موازی روی کل آرایه انتظار میرود. Sort با ۱۱۴.۵۱ms روی ۳ فریم پخش شده، بدون اینکه هیچ فریمی بیشتر از ۶۰ms طول بکشد، یعنی Hitch محسوسی تولید نمیکند. اسکرول هم در بدترین لحظه فقط ۱۰.۶۲ms طول کشیده؛ یعنی Object Pooling و Virtualization طبق انتظار کار میکنند و هیچکدام از عملیاتهای سنگین (Load، Sort، Search، Scroll) فریمریت را بهشکل محسوسی پایین نمیآورند.
نحوهٔ اجرا و تست
- مسیر فایل CSV را در فیلد
pathرویManager(یاTestParse،SortJobTests،LeaderboardProfilerReportبرای تست جدا) ست کن. - Play بزن؛ ترتیب اجرا: Read → Find Lines → Parse → Sort → نمایش اولیه → آمادهسازی Search.
- برای تست جستجو، داخل UI عدد (ID) یا بخشی از نام کاربری را تایپ کن.